- 1·第1讲:强化学习简介I
- 2·第1讲:强化学习简介II
- 3·第1讲:强化学习简介III
- 4·第2讲:探索与利用
- 5·第3讲:马尔可夫决策过程I
- 6·第3讲:马尔可夫决策过程II
- 7·第4讲:动态规划
- 8·第5讲:值函数估计I
- 9·第5讲:值函数估计II
- 10·第6讲:无模型控制方法I
- 11·第6讲:无模型控制方法II
- 12·第7讲:规划与学习I
- 13·第7讲:规划与学习II
- 14·第8讲:参数化的值函数和策略I
- 15·第8讲:参数化的值函数和策略II
- 16·第9讲:深度强化学习价值方法I
- 17·第9讲:深度强化学习价值方法II
- 18·第10讲:深度强化学习策略方法I
- 19·第10讲:深度强化学习策略方法II
- 20·第11讲:基于模型的深度强化学习I
- 21·第11讲:基于模型的深度强化学习II
- 22·第11讲:基于模型的深度强化学习III
- 23·第12讲:模仿学习I
- 24·第12讲:模仿学习II
- 25·第13讲:离线强化学习
- 26·第14讲:多智能体强化学习I
- 27·第14讲:多智能体强化学习II
- 28·第14讲:多智能体强化学习III
- 29·第14讲:多智能体强化学习IV
- 30·第15讲:AI Agent与决策大模型I
- 31·第15讲:AI Agent与决策大模型II
- 32·第15讲:AI Agent与决策大模型III
- 33·第16讲:基于扩散模型的强化学习
课程介绍
内容简介:这门课到底讲了什么
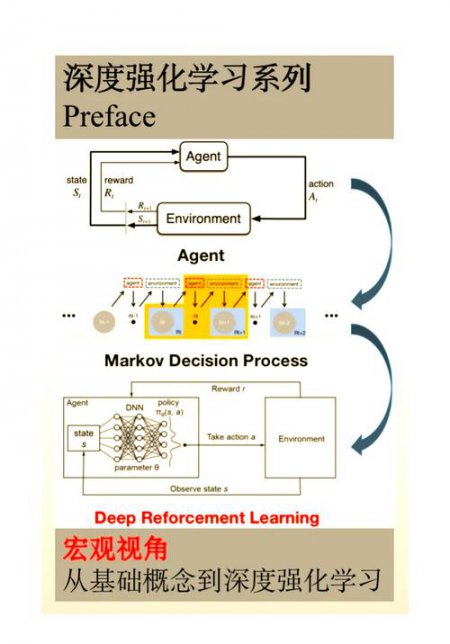
内容简介:上交大公开课【动手学强化学习】2026完整版33集!这绝对是我看过最好的深度强化学习课程,也是我近两年刷完的中文强化学习教程里,知识链条最完整的一套。它从最基础的概念讲起,一路推到AI Agent与决策大模型,中间没有明显断档。
很多人学强化学习卡在两个地方:一是数学符号看不懂,二是代码跑不起来。这套课把马尔可夫决策过程、值函数估计、策略梯度这些硬骨头拆成小段讲,配合课件源码,边看边敲能跟上节奏。33集看着多,其实每集时长控制得比较克制,通勤路上刷两集不算负担。
哪些人适合跟这套课
实际教学里我发现,报名强化学习方向的同学背景差异特别大,所以这里给几个具体画像,对号入座更省时间:
- 有机器学习基础的研究生:已经学过监督学习、会写PyTorch,想补上决策与序列决策这块短板,直接从第5讲往后看效率最高。
- 做推荐、运筹、机器人方向的工程师:工作需要落地序列决策模型,前面几讲可以快进,重点啃第9到第11讲的深度强化学习方法。
- 准备转行AI的零基础同学:不建议直接冲,先补Python和概率统计,再按顺序从头看,进度慢但不会崩。
- 想做大模型Agent方向的人:第15讲那三集AI Agent与决策大模型,是很多同类课程还没覆盖到的内容。
坦白说,完全没接触过概率论和线性代数的同学,硬啃会痛苦。我带的学员里,约八成能坚持下来的,都是提前补过数学基础的。
课程大纲速览:16讲33集
目录结构是递进的,前面打地基,中间讲方法,后面追前沿。整理成表格方便你规划进度:
| 讲次 | 主题 | 集数 |
|---|---|---|
| 第1讲 | 强化学习简介 | 3集 |
| 第2讲 | 探索与利用 | 1集 |
| 第3讲 | 马尔可夫决策过程 | 2集 |
| 第4讲 | 动态规划 | 1集 |
| 第5讲 | 值函数估计 | 2集 |
| 第6讲 | 无模型控制方法 | 2集 |
| 第7讲 | 规划与学习 | 2集 |
| 第8讲 | 参数化的值函数和策略 | 2集 |
| 第9讲 | 深度强化学习价值方法 | 2集 |
| 第10讲 | 深度强化学习策略方法 | 2集 |
| 第11讲 | 基于模型的深度强化学习 | 3集 |
| 第12讲 | 模仿学习 | 2集 |
| 第13讲 | 离线强化学习 | 1集 |
| 第14讲 | 多智能体强化学习 | 4集 |
| 第15讲 | AI Agent与决策大模型 | 3集 |
| 第16讲 | 基于扩散模型的强化学习 | 1集 |
能看到,第14讲多智能体占了4集,第15讲Agent占3集,说明课程重心确实往当下热门方向倾斜了,不是老课换个封面。
分阶段学习路径建议
按我给学员排的计划,大致分三段走,别一口气全刷完,容易半途弃坑。
第一阶段(2到3周):第1讲到第6讲,每天1集,重点是弄懂MDP五元组和贝尔曼方程的推导,动手把动态规划的格子世界代码跑通。
第二阶段(3到4周):第7讲到第11讲,这是全课最密的区域,DQN、策略梯度、Actor-Critic都会出现,建议每讲配一个开源环境复现,CartPole或Atari都行。
第三阶段(2周):第12讲到第16讲,模仿学习、离线强化学习、多智能体、Agent,这部分偏前沿,看懂思路比跑通代码更重要,配合资料包里的实战项目案例一起消化。
这套课的差异化在哪
市面上强化学习资源不少,David Silver的课理论深但代码弱,一些付费课代码多但理论浅。这套上交大公开课【动手学强化学习】2026完整版33集的优势是两边都顾上了:课件、源码、笔记三件套齐全,讲完概念立刻能动手验证。
另外课程更新到2026年,把扩散模型、决策大模型、离线强化学习这些新东西收了进来,学完不至于发现知识已经过时两年。对找工作的人来说,简历上能写"做过离线强化学习项目",比只写"了解DQN"有分量得多。
常见问题
零基础能直接学吗?
零基础能学这套强化学习教程吗?
能学,但要有心理准备。建议先掌握Python基础和大学概率统计,再从头按顺序看,前六讲不要跳,跳了后面会反复回来补。
学完能做什么方向的工作?
学完能做什么?
可以往推荐系统、机器人控制、游戏AI、运筹优化、大模型Agent几个方向投。岗位通常要求算法工程能力,所以简历里一定要有跑通的项目,光看完视频不够。
和吴恩达的课程有什么区别?
和别的强化学习课有什么区别?
吴恩达体系偏监督学习与深度学习基础,强化学习只占一小块。这套是专项课,从MDP一直讲到多智能体和扩散模型,深度上更集中,但前提是你已经有机器学习底子。
33集要学多久?
全部学完大概要多久?
纯看视频大约三周,但如果每讲都动手复现代码,两到三个月是正常节奏。急着交作业的可以只看第9到第11讲,够应付多数课程项目。
一点学习寄语
强化学习是那种"看懂了"和"跑通了"之间隔着一条河的方向。这套课的价值不在于让你看完就成专家,而在于把河上的桥搭好了,剩下的路要自己走。遇到公式推不动的时候,别硬扛,回头把前一讲重看一遍,往往就通了。
课件代码和学习路线资料包在课程页有整理,需要的话可以顺手存下来,跟着节奏一步步来,两三个月后回头看,你会庆幸自己没在半路放弃。